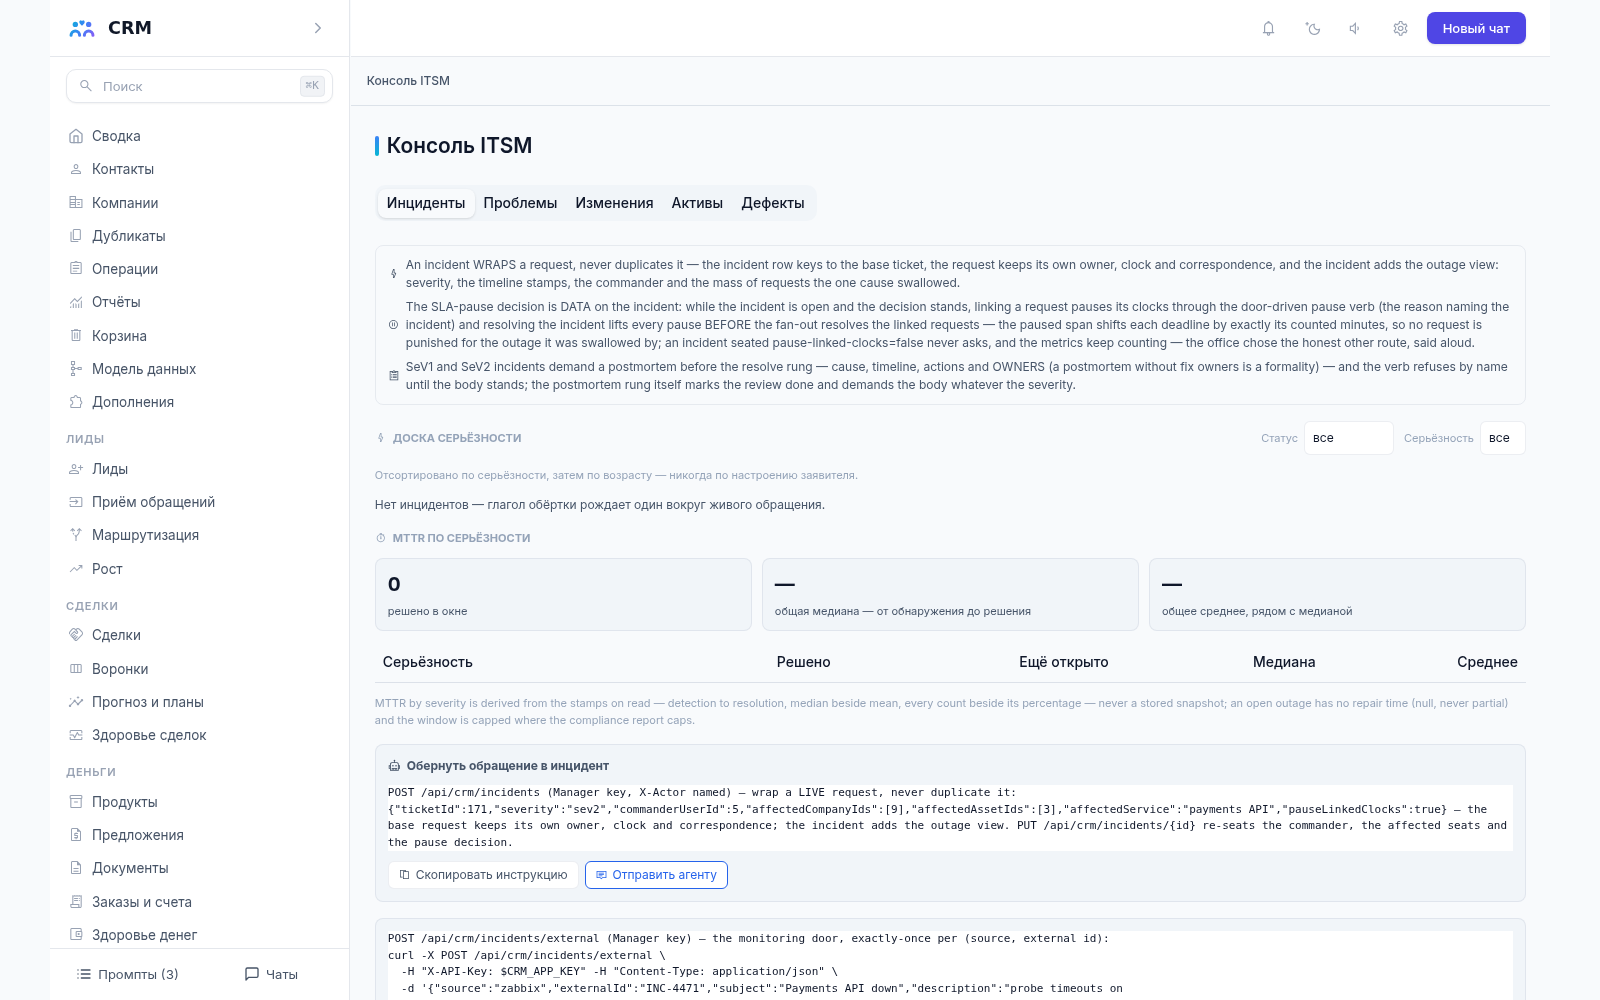
Надстройка «ITSM» — для IT- и сервисных команд. Она отвечает на четыре вопроса: что сломалось прямо сейчас, почему это повторяется, что мы собираемся менять и что вообще обслуживается. Рядом с заявками живёт учёт дефектов — ошибок в ваших собственных продуктах. Управление собрано в «Консоли ITSM» с вкладками «Инциденты», «Проблемы», «Изменения», «Активы» и «Дефекты».
Зачем это нужно
Заявку можно закрыть, а причину — нет. Когда один и тот же сбой приходит в третий раз, поддержка тушит пожары поштучно, а клиенты пишут «у вас опять всё упало». При этом никто не знает, какие работы планируются на выходные, у какого клиента стоит какой сервер и до какой даты он вообще обслуживается. Знания живут в переписке и в голове одного инженера.
«ITSM» превращает это в четыре понятных объекта. Инцидент показывает картину сбоя и объединяет пострадавшие заявки, проблемы хранят причины повторяющихся поломок вместе с готовым обходным путём, изменения ведутся с планом отката и согласованием, а реестр активов отвечает на вопрос «что и где у нас обслуживается». Выясняется это заранее, а не во время сбоя.
Что умеет
- Инцидент — обёртка над заявкой, а не вторая заявка. Заявка остаётся обычной: со своим ответственным, своей перепиской и своим сроком. Инцидент добавляет к ней картину сбоя: серьёзность выбирает команда (от первой до четвёртой — клиент сбой не оценивает), ступени «обнаружено → разбираемся → снижаем последствия → наблюдаем → решено → разбор после инцидента» с отметками времени, назначенный командир инцидента, затронутые компании, активы и сервис, а также место под ссылку на страницу состояния.
- Крупный инцидент объединяет заявки. Одна явная команда привязывает много живых заявок к одному открытому инциденту: одна заявка в один момент держится только одним открытым инцидентом, а каждый пропуск назван, а не забыт.
- Часы у пострадавших останавливаются. Решение о паузе — данные на самом инциденте, и по умолчанию она включена. Пока инцидент стоит, привязка заявки останавливает её сроки, а в журнал идёт причина с именем инцидента. Пауза держится даже когда клиент пишет в заявку, и снимается только своим выходом: закрытием инцидента или отвязкой. Единый акт закрытия решает все незакрытые привязанные заявки разом — с отметкой «решено в рамках инцидента» и одним уведомлением ответственному. Заявку, которую закрыли чужой рукой, проходят мимо, записав это в журнал.
- Тяжёлый сбой без разбора не закрыть. Для серьёзности первого и второго уровней продукт требует разбор: что случилось, хронология, принятые меры и ответственные. Пока разбора нет, инцидент закрыть нельзя — отказ называется прямо.
- Время восстановления видно сразу. Отчёт считает время от обнаружения до решения — и медианой, и средним, с количеством по каждому уровню серьёзности. Отчёт строится из отметок времени, а не из чьей-то сводки.
- Проблемы — «почему повторяется». Проблема заводится с обязательным ответственным (без реального человека это формальность) и сервисом, и проходит лестницу «новая → разбираемся → известная ошибка → решена → закрыта». Ворота стоят на ступенях: «известная ошибка» требует обходной путь и запись о ней, «решена» требует первопричину, а закрыть можно только решённую. Записи никогда не удаляются — закрытая ступень запечатывает историю.
- Число повторов считается, а не хранится. Повторяемость выводится из связей с инцидентами. Свежий инцидент, назвавший сервисное слово открытой проблемы внутри окна в 30 дней, привязывается к ней сам — с записью в обоих журналах. Пустое слово, старое окно или двусмысленное совпадение (две открытые проблемы с одним словом) не привязываются: выбирает человек.
- Известная ошибка публикуется в базу знаний. Это отдельная явная команда: одна открытая статья на запись, симптом берётся словами клиента, обходной путь переносится дословно, а владелец проблемы становится владельцем статьи. Без надстройки «База знаний» команда отказывает по имени, а карточка честно говорит, почему статья не опубликована. Опубликованная статья сама попадает в подсказки при заявках — как обычная открытая статья.
- Обходной путь виден там, где нужен. На каждой заявке, которую накрыла открытая проблема, показывается стоящий обходной путь. Сотрудник отвечает на третье повторение одной и той же поломки готовым решением, пока настоящая починка ждёт.
- Проблемы по важности. Отчёт ставит открытые проблемы сначала по повторяемости, потом по возрасту, и рядом с каждой строкой печатает объём накрытых заявок и имя ответственного — видно, что чинить первым.
- Изменение — с окном и владельцем. «Что мы собираемся менять» заводится как отдельный объект с обязательным ответственным и обязательной парой окон (начало и конец): изменение без окна — это пожелание. В нём есть слово риска, план отката, план проверки, связанные проблемы и инциденты, затронутые компании и активы.
- Тип изменения решает маршрут и фиксируется при отправке. Стандартное предодобрено своим типом и цепочку не проходит. Обычное и срочное отправляются вместе с цепочкой согласования: одна или две ступени, у каждой свой согласующий и свой срок, вторая ступень отсчитывается только после решения первой. Одобрение приходит исключительно решением цепочки — сама контора утвердить обычное изменение не может. Срочное изменение платит за ускорение обязательным разбором при закрытии. Отправка обычного и срочного требует плана отката, иначе отказ по имени.
- Молчащий согласующий не тормозит работу. Каждое решение — неизменяемая запись: при отказе комментарий обязателен, а правки невозможны вовсе. Раз в час проходит проверка просроченных ступеней: она отмечает ступень, отправляет по одному уведомлению согласующему и владельцу изменения и пишет это в журнал. Просрочка — только отметка, а не решение: ступень остаётся решаемой, а изменение не двигается вперёд на молчании.
- Закрытие требует результата. Чтобы закрыть изменение, нужен текст результата и отметка проверки, а для срочного — ещё и разбор: «сработало» — это утверждение, а результат говорит, что именно сделано. «Откатили» — отдельный честный итог: он доступен только из внедрения или проверки и требует своего пояснения. Доля срочных изменений считается рядом с количеством и знаменателем, и при 80% продукт прямо предупреждает, что срочное стало нормой.
- Календарь и письма о работах. Календарь изменений строится по окнам в момент открытия: изменение, пересекающее границу месяца, видно в обоих. Затронутые компании получают одно письмо о предстоящих работах на изменение; компании без живого адреса пропускаются по имени, а повторный прогон отказывает.
- Реестр активов. Он отвечает на один вопрос: какой сервер, у какого клиента, в каких инцидентах. Виды: сервер, рабочая станция, сетевое оборудование, мобильное устройство, программа, лицензия, сервис и облачный ресурс. У актива есть опознавательные места (инвентарный номер, серийный номер, внешний идентификатор), компания-владелец и закреплённый сотрудник, адрес места, состояние, критичность и срок гарантии. Действует закон о дубликатах: один и тот же физический объект не может войти дважды — совпадение отказывает по имени и называет стоящую строку, а пустые места не сталкиваются между собой.
- Связи и критичность. Актив связывается с компанией, сотрудником, заявкой, инцидентом, изменением или договором — по одной стоящей связи на пару. Если актив помечен как критичный, его связь с заявкой поднимает рабочий приоритет заявки до срочного; подъём происходит ровно один раз, с записью об авторстве, никогда не понижается и не отменяется при снятии связи — это факт, а не временное право. Актив со стоящими связями не удаляется: предлагается списание с обязательной причиной, а без связей строка уходит вместе со своим журналом. Каждое движение остаётся в журнале обслуживания.
- Заведение списка файлом. Перед импортом выбирается ключ сопоставления — серийный номер, инвентарный номер или внешний идентификатор. Пробный прогон отвечает точной сверкой и не записывает ничего, а исполнение даёт те же числа: сколько создано, сколько обновлено, сколько отказано из-за дубликата — и каждый отказ называет свою строку.
- Дефекты: свои ошибки под контролем. У дефекта есть продукт и компонент, версия находки и версия исправления (её ставит только команда выпуска), своя серьёзность и свой приоритет, обязательный ответственный и место под номер в чужом трекере. Дефект заводится из заявки и переносит контекст, но не чужие решения: шаги воспроизведения копируют текст заявки дословно (с названной обрезкой), вложения переносятся ссылками, поэтому байты не дублируются, тема по умолчанию берётся из заявки — а ответственный, серьёзность и приоритет берутся только из самого дефекта. Десять обычных заявок от крупнейшего клиента весят больше одной срочной.
- Связи дефекта, дубликаты и выпуск. Каждая связь с заявкой несёт направление: «симптом» — заявка вскрыла дефект, «затронуто» — дефект касается клиента этой заявки; одна стоящая связь на пару. Лестница «новая → разобрана → в работе → исправлена → проверена → выпущена» с отдельными исходами «не исправим» (с обязательной причиной) и «дубликат»: при дубликате надо назвать выживающий дефект, и масса связей переезжает на него, а повторов не остаётся. Выпуск требует версию исправления: на каждую связанную заявку ложится отметка «исправлено в версии…», но закрываются только те заявки, которые названы в команде — выпуск никогда не закрывает заявку молча, а закрытие заявки никогда не закрывает её дефект.
- Письмо клиентам об исправлении. Это отдельное действие с одним шаблоном: рассылка идёт по всем связанным заявкам, отказ на конкретной заявке уважается и называется, заявки без контакта или адреса пропускаются по имени, каждое отправленное письмо записывается в журнал вместе со списком получателей, и всё это один раз на дефект.
- Отчёт «кто под ударом». Дефекты, связанные заявки и клиенты считаются из связей в момент открытия; сверху идут дефекты, задевшие больше всего клиентов, — исправлять нужно их. На карточке заявки видно, какой дефект её касается, исправлен ли он и в какой версии.
- Быстрая регистрация сбоя. Система мониторинга может сообщить о сбое сама, через отдельный адрес API: повторная доставка того же события ничего не удваивает — она отвечает уже стоящим инцидентом.
Как это связано с другими надстройками
«ITSM» опирается на «Сервис» и «Базу знаний». Без «Сервиса» нечего оборачивать и нечего связывать — заявок просто нет. Без базы знаний известную ошибку некуда публиковать: команда публикации отказывает по имени, а всё остальное в надстройке продолжает работать. Каталог надстроек не даст отметить ITSM, пока не установлены обе.
С «SLA» связь практическая: часы заявок останавливает крупный инцидент, а сами часы ведёт SLA. Без SLA никаких часов нет, поэтому и паузить нечего. На ITSM, в свою очередь, опираются «Договоры»: покрытие договора задаётся по активам из реестра.
Честные границы
- Похожие заявки не собираются в инцидент автоматически, публичных страниц состояния для клиентов и дежурных графиков нет — это названные отсрочки.
- Проблемы не находятся сами по инцидентам: ключ — сервисное слово, а привязка остаётся делом человека.
- Отдельной базы известных ошибок нет: запись живёт при проблеме и публикуется одной статьёй в базу знаний.
- Совещаний по изменениям, библиотек типовых шаблонов и автоматического создания изменений из развёртывания нет — есть типы маршрутов и цепочка согласования.
- Полноценного учёта конфигураций не будет: классы, типы связей, карты сервисов и автоматическое обнаружение устройств не сделаны. Реестр отвечает на один вопрос — что и где обслуживается.
- Двусторонней синхронизации с чужим трекером ошибок нет: есть только место под внешний номер, потому что один источник правды лучше двух.
- Приоритет заявки не поднимается автоматически по числу обращений: отчёт показывает, кто под ударом, а решение принимает человек.
Все надстройки → Каталог надстроек